Linear Algebra
๐Ÿšš

Chapter 4. Multi-Layer Perceptron

์ƒ์„ฑ์ผ
2022/01/19 13:48
ํƒœ๊ทธ
MLP
Overfitting
Weight Decay
Dropout

4.1 Multilayer Perceptrons

์•ž์„  ๋‹จ์›์—์„œ ์šฐ๋ฆฌ๋Š” ์„ ํ˜• ๋ชจ๋ธ์„ ์‚ดํŽด๋ณด์•˜์Šต๋‹ˆ๋‹ค.
o^=softmaxโก(Wx+b)\hat{\mathbf{o}}=\operatorname{softmax}(\mathbf{W} \mathbf{x}+\mathbf{b})
์œ„์™€ ๊ฐ™์€ ํ˜•ํƒœ๋กœ ํ‘œํ˜„ํ•ด ์ฃผ์–ด์ง„ ๋ฐ์ดํ„ฐ๊ฐ€ ์–ด๋А ์นดํ…Œ๊ณ ๋ฆฌ์— ์œ„์น˜ํ•˜๋Š”์ง€ ์„ ํ˜•ํ•จ์ˆ˜์˜ ํ˜•ํƒœ๋กœ ์ฃผ์–ด์กŒ์Šต๋‹ˆ๋‹ค. ๊ทธ๋Ÿฌ๋‚˜ ์ด๋Ÿฌํ•œ ์„ ํ˜•ํ•จ์ˆ˜๋Š” ์ž…๋ ฅ๋“ค์ด ๋ฐ”๋กœ ์ถœ๋ ฅ์œผ๋กœ ๋งคํ•‘๋˜๊ณ  ์ด๋Š” ๋„ˆ๋ฌด ๊ฐ•ํ•œ ๊ฐ€์ •์ž…๋‹ˆ๋‹ค. ๋งˆ์น˜ ๋„Œ Aํ˜•์ด๋‹ˆ๊นŒ~ ์†Œ์‹ฌํ•˜๊ฒ ์ง€ ๋ญ~ ๋ผ๊ณ  ๋ฐ”๋กœ ๋‹จ์–ธํ•ด๋ฒ„๋ฆฌ๋Š” ๊ฒƒ๊ณผ ๊ฐ™์Šต๋‹ˆ๋‹ค. ์„ธ์ƒ ์‚ฌ๋žŒ๋“ค์ด ๋‹ค ์ œ๊ฐ๊ฐ์ด๋“ฏ์ด ํ•˜๋‚˜์˜ ํŠน์ง•์„ ํ†ตํ•ด ๋ฐ”๋กœ ํ•˜๋‚˜์˜ ๊ฒฐ๋ก ์œผ๋กœ ๋งค๋“ญ์ง“๊ธฐ์—” ๋„ˆ๋ฌด ๋…ผ๋ฆฌ์˜ ๋น„์•ฝ์ด ํฝ๋‹ˆ๋‹ค.
์ด๋Ÿฌํ•œ ์ถ”๋ก ์„ ๋ฐฉ์ง€ํ•˜๊ธฐ ์œ„ํ•ด์„  ์šฐ๋ฆฐ ์—ฌ๋Ÿฌ ์š”์†Œ๋“ค์„ ๋ณตํ•ฉ์ ์œผ๋กœ ๊ณ ๋ คํ•ด์•ผ ํ•ฉ๋‹ˆ๋‹ค.
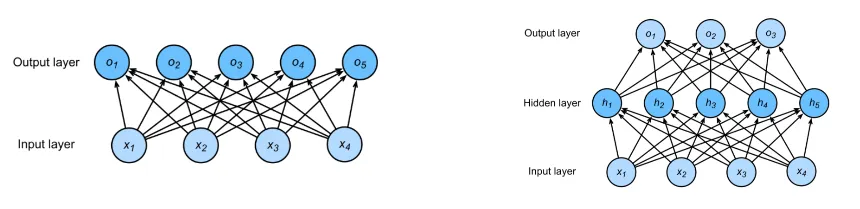
์ž…๋ ฅ๊ณผ ์ถœ๋ ฅ ์‚ฌ์ด์˜ ๋ณต์žกํ•œ ๊ด€๊ณ„๋ฅผ ์ฐพ๊ธฐ ์œ„ํ•ด์„  ํŒจํ„ด ํ˜•์„ฑ์— ๊ด€์—ฌํ•˜๋Š” ์ˆ˜๋งŽ์€ ํŠน์„ฑ๋“ค์„ ๊ณ ๋ คํ•ด์•ผํ•˜๊ณ  ์ด๋ฅผ ์œ„ํ•ด์„œ ์šฐ๋ฆฌ๋Š” ์—ฌ๋Ÿฌ๊ฐœ์˜ hidden layers๋ฅผ ์‚ฌ์šฉํ•˜์—ฌ ๋ชจ๋ธ์„ ๊ตฌ์„ฑํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ๊ฐ layer์˜ ๊ฒฐ๊ณผ๋Š” ๋‹ค์Œ layer์˜ ์ž…๋ ฅ์œผ๋กœ ์—ฐ๊ฒฐ๋˜๊ณ  ์ฐจ๋ก€ ์ฐจ๋ก€ ์ด์–ด์ ธ์„œ ์ถœ๋ ฅ์ธต๊นŒ์ง€ ์ด์–ด์ง‘๋‹ˆ๋‹ค. ์ด๋Ÿฌํ•œ ์•„ํ‚คํ…์ณ๋ฅผ Multilayer Perceptron์ด๋ผ๊ณ  ํ•ฉ๋‹ˆ๋‹ค. ์ด๋Ÿฌํ•œ Multilayer Perceptron์€ ์—ฌ๋Ÿฌ ๊ฐœ์˜ layers์˜ ๋‰ด๋Ÿฐ๋“ค์ด ์„œ๋กœ Fully Connected๋œ ํ˜•ํƒœ๋ฅผ ๊ฐ€์ง‘๋‹ˆ๋‹ค.
์ด๋Ÿฌํ•œ ๋ณต์žกํ•œ ๋ชจ๋ธ์„ ๋‹ค๋ฃจ๊ธฐ ์‹œ์ž‘ํ•˜๋ฉด์„œ ๋“ฑ์žฅํ•˜๋Š” ๋ฌธ์ œ๋“ค์ด ๋ฐ”๋กœ overfitting, underfitting์ž…๋‹ˆ๋‹ค. ์œ„์˜ ๋ฌธ์ œ์ ๋“ค์„ ํ•ด๊ฒฐํ•˜๊ธฐ ์œ„ํ•ด weight decay, dropout ๋“ฑ์˜ regularization techniques์„ ์ด์šฉํ•ฉ๋‹ˆ๋‹ค. ๋˜ํ•œ ๋„คํŠธ์›Œํฌ๋ฅผ ์„ฑ๊ณต์ ์œผ๋กœ ํŠธ๋ ˆ์ด๋‹ ์‹œํ‚ค๊ธฐ ์œ„ํ•œ numerical stability ์™€ parameter initialization์„ ๋‹ค๋ฃฌ๋‹ค.

4.1.1 Hidden Layers

์œ„์— ์ œ์‹œ๋œ ํ˜•ํƒœ์—์„œ ๊ธฐ๋ณธ์ ์ธ ์ •๋ณด๋ฅผ ํ‘œํ˜„ํ•˜๋ฉด, ์ž…๋ ฅ์ด 4๊ฐœ, ์ถœ๋ ฅ์ด 3๊ฐœ, 1๊ฐœ์˜ hidden layer๊ฐ€ 5๊ฐœ์˜ hidden unit์„ ๊ฐ€์ง€๋Š” ํ˜•ํƒœ์ž…๋‹ˆ๋‹ค. ์ธต์˜ ๊ฐœ์ˆ˜๋Š” ์ž…๋ ฅ์ธต์„ ์ œ์™ธํ•œ 2๊ฐœ์ž…๋‹ˆ๋‹ค.

4.1.2 Activation Functions

h=ฯƒ(W1x+b1)o=W2h+b2y^=softmaxโก(o)\begin{aligned}&\mathbf{h}=\sigma\left(\mathbf{W}_{1} \mathbf{x}+\mathbf{b}_{1}\right) \\&\mathbf{o}=\mathbf{W}_{2} \mathbf{h}+\mathbf{b}_{2} \\&\hat{\mathbf{y}}=\operatorname{softmax}(\mathbf{o})\end{aligned}
Activationย function์€ ์ž…๋ ฅ๋œ ๋ฐ์ดํ„ฐ์˜ ๊ฐ€์ค‘ ํ•ฉ์„ ์ถœ๋ ฅ ์‹ ํ˜ธ๋กœ ๋ณ€ํ™˜ํ•˜๋Š”ย ํ•จ์ˆ˜์ด๋‹ค. ์ธ๊ณต ์‹ ๊ฒฝ๋ง์—์„œ ์ด์ „ ๋ ˆ์ด์–ด์— ๋Œ€ํ•œ ๊ฐ€์ค‘ ํ•ฉ์˜ ํฌ๊ธฐ์— ๋”ฐ๋ผย ํ™œ์„ฑย ์—ฌ๋ถ€๊ฐ€ ๊ฒฐ์ •๋ฉ๋‹ˆ๋‹ค. ์ด๋Ÿฌํ•œ Activationย function์„ ์‚ฌ์šฉํ•  ๋•Œ ์ฃผ๋กœ ๋น„์„ ํ˜• ํ•จ์ˆ˜๋ฅผ ์‚ฌ์šฉํ•ฉ๋‹ˆ๋‹ค. ๊ทธ ์ด์œ ๋Š” ์„ ํ˜•ํ•จ์ˆ˜๋ฅผ Activationย function์œผ๋กœ ์‚ฌ์šฉํ•˜๋ฉด ์ธต์„ ๊นŠ๊ฒŒ ํ•˜๋Š” ์˜๋ฏธ๊ฐ€ ์—†์ด ๊ทธ๋ƒฅ ์„ ํ˜•ํ•จ์ˆ˜๊ฐ€ ๋˜์–ด ๋ฒ„๋ฆฌ๊ธฐ ๋•Œ๋ฌธ์ž…๋‹ˆ๋‹ค. y(x)=h(h(h(x)))๋ผ๋Š” ์‹์—์„œ h(x) = cx ๋ผ๊ณ  ๊ฐ€์ •ํ•˜๋ฉด y(x)=c3(x)y(x) = c^3(x) ์˜ ์„ ํ˜•ํ•จ์ˆ˜๊ฐ€ ๋˜์–ด ๋ฒ„๋ฆฐ๋‹ค.
๊ทธ๋ ‡๋‹ค๋ฉด Activationย function์—๋Š” ์–ด๋–ค ์ข…๋ฅ˜๊ฐ€ ์žˆ์„๊นŒ?

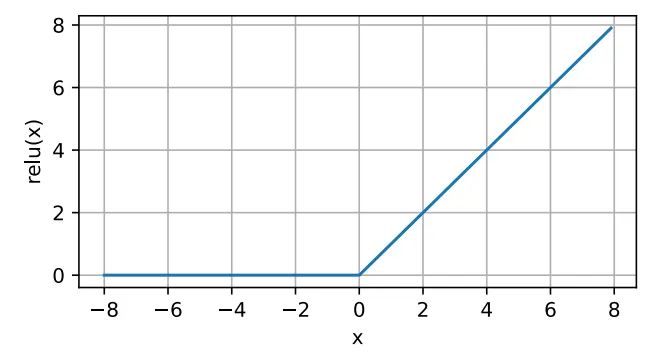
ReLU Function (most frequently used)

๊ฐ€์žฅ ๊ตฌํ˜„ํ•˜๊ธฐ ๋‹จ์ˆœํ•œ ํ˜•ํƒœ๋ฅผ ๊ฐ€์ง€๊ณ  ์žˆ๊ณ  ํผํฌ๋จผ์Šค ๋˜ํ•œ ์ข‹๊ธฐ ๋•Œ๋ฌธ์— ๊ฐ€์žฅ ๋งŽ์ด ์‚ฌ์šฉ๋˜๋Š” ํ•จ์ˆ˜์ด๋‹ค. ReLU๋ฅผ ์‚ฌ์šฉํ•˜๋Š” ๊ฐ€์žฅ ํฐ ์ด์œ ๋Š” ๊ธฐ์šธ๊ธฐ ๊ฐ’์ด 0์ด์ƒ์˜ ์ž…๋ ฅ์— ๋Œ€ํ•ด์„œ 1์ด๊ธฐ ๋•Œ๋ฌธ์— ๊ธฐ์šธ๊ธฐ ๊ฐ’์ด ์‚ฌ๋ผ์ง€์ง€ ์•Š๊ณ  ๊ณ„์† ์œ ์ง€๋˜๊ธฐ ๋•Œ๋ฌธ์— ๋’ค์— ํ›„์ˆ ํ•  Gradient Vanishing ๋ฌธ์ œ์— ๋Œ€ํ•ด ์ž์œ ๋กญ๋‹ค.
ReLUโก(x)=maxโก(x,0)\operatorname{ReLU}(x)=\max (x, 0)

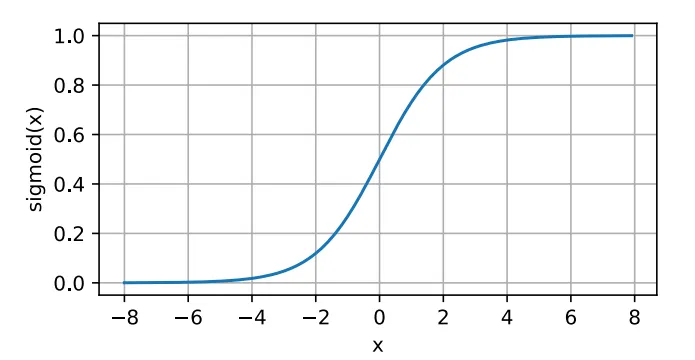
Sigmoid Function

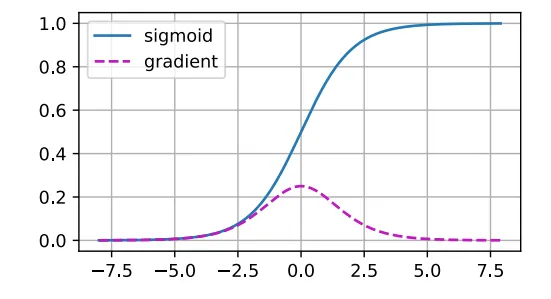
์–ด๋– ํ•œ ์ž…๋ ฅ์„ ๋„ฃ๋“  (0,1) ์‚ฌ์ด์˜ ๊ฐ’์œผ๋กœ ๋ณ€ํ™˜ํ•ด ์ฃผ๋Š” ํ•จ์ˆ˜์ด๋‹ค. Sigmoid๋Š” ๋งค์šฐ ๋งค๋„๋Ÿฌ์šด ํ˜•ํƒœ์˜ ๊ณก์„ ์œผ๋กœ ๊ธฐ์šธ๊ธฐ๊ฐ€ ๊ธ‰๊ฒฉํ•˜๊ฒŒ ๋ณ€ํ•˜์ง€ ์•Š๊ธฐ ๋•Œ๋ฌธ์— Gradient Exploding ํ˜„์ƒ์ด ๋ฐœ์ƒํ•˜์ง€๋Š” ์•Š์ง€๋งŒ, ๋Œ€๋ถ€๋ถ„์˜ ์ž…๋ ฅ์— ๋Œ€ํ•ด ๊ธฐ์šธ๊ธฐ๊ฐ€ 0์ธ ๊ฐ’์„ ๊ฐ€์ง€๊ธฐ ๋•Œ๋ฌธ์— ์•ž ๋…ธ๋“œ์˜ ๊ฐ’์ด ์–ด๋–ค ๊ฐ’์ด์—ˆ๋Š”์ง€ ์ƒ๊ด€ ์—†์ด ๊ธฐ์šธ๊ธฐ๊ฐ€ ์†Œ๋ฉธํ•ด๋ฒ„๋ฆฌ๋Š” Gradient Vanishing ํ˜„์ƒ์ด ๋ฐœ์ƒํ•œ๋‹ค. ์ฆ‰, ๋‹ค์Œ layer์— ์•„๋ฌด ๊ฒƒ๋„ ์ „๋‹ฌ๋˜์ง€ ์•Š๋Š” ํ˜„์ƒ์ด ๋ฐœ์ƒํ•ด ์‹ ํ˜ธ๊ฐ€ ์ „๋‹ฌ๋˜์ง€ ์•Š๋Š”๋‹ค.
sigmoidโก(x)=11+expโก(โˆ’x)\operatorname{sigmoid}(x)=\frac{1}{1+\exp (-x)}

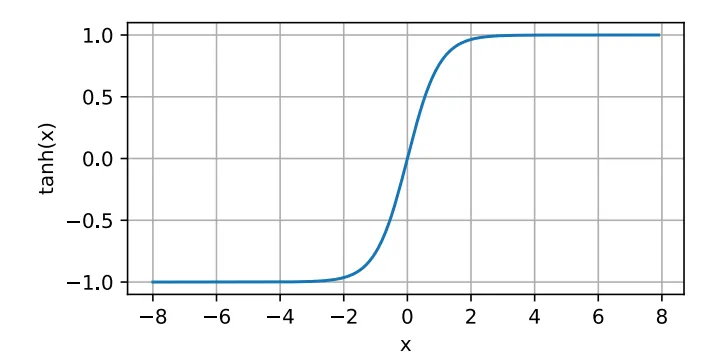
Tanh Function

tanhโก(x)=1โˆ’expโก(โˆ’2x)1+expโก(โˆ’2x)\tanh (x)=\frac{1-\exp (-2 x)}{1+\exp (-2 x)}

4.4 Model Selection, Underfitting, and Overfitting

๋”ฅ๋Ÿฌ๋‹์„ ํฌํ•จํ•œ ๋จธ์‹ ๋Ÿฌ๋‹ ์•Œ๊ณ ๋ฆฌ์ฆ˜์—์„œ ๊ฐ€์žฅ ์ค‘์š”ํ•œ ๊ฒƒ์€ ํŒจํ„ด์„ ์ฐพ๋Š”๊ฒƒ์ž…๋‹ˆ๋‹ค.
ํ•˜์ง€๋งŒ ์šฐ๋ฆฌ๋Š” ๋‹จ์ˆœํžˆ ํŒจํ„ด์„ ๊ธฐ์–ตํ•˜๋Š” ๊ฒƒ์ด ์•„๋‹Œ ์ฒ˜์Œ๋ณด๋Š” ์œ ํ˜•์— ๋Œ€ํ•ด์„œ๋„ ๋Œ€์‘ํ•  ์ˆ˜ ์žˆ๋Š” ์•Œ๊ณ ๋ฆฌ์ฆ˜์„ ๋งŒ๋“ค์–ด์•ผ ํ•ฉ๋‹ˆ๋‹ค. ํŠน์ • ์ƒํ™ฉ์—์„œ๋งŒ ์‚ฌ์šฉ๋˜๋Š” ๋ชจ๋ธ์€ ์‚ฌ์šฉํ•  ์ˆ˜ ์—†๊ณ , ์ „ํ˜€ ๋ณด์ง€ ๋ชปํ•œ ๊ฒƒ์— ์˜ˆ์ธก ํ•  ์ˆ˜ ์žˆ์–ด์•ผ ํ•ฉ๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ์ผ๋ฐ˜์ ์ธ ํŒจํ„ด์„ ์ฐพ๋Š”๊ฒƒ์ด ๊ฐ€์žฅ ์ค‘์š”ํ•ฉ๋‹ˆ๋‹ค.
ํ•˜์ง€๋งŒ ์šฐ๋ฆฌ๊ฐ€ ์ ‘๊ทผํ•˜๋Š” ๋ฐ์ดํ„ฐ์˜ ์–‘์€ ์ „์ฒด ๋ฐ์ดํ„ฐ ์–‘์˜ ์ž‘์€ ์ผ๋ถ€๋ถ„์ผ ๋ฟ์ž…๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ์˜ฌ๋ฐ”๋ฅธ ์˜ˆ์ธก์„ ํ•˜๊ธฐ๊ฐ€ ์–ด๋ ต๊ณ , ๋ชจ๋ธ์ด ์‹ค์ œ ๋ถ„ํฌ๋ณด๋‹ค Training dataset ๋ถ„ํฌ์—๋งŒ ๋” ๊ทผ์ ‘ํ•˜๊ฒŒ ๋˜๋Š” ํ˜„์ƒ์ด ๋ฐœ์ƒํ•˜๊ฒŒ ๋˜๋ฉฐ, ์ด๋ฅผ Overfitting์ด๋ผ๊ณ  ํ•ฉ๋‹ˆ๋‹ค.

4.4.1 Training Error and Generalization Error

Overfitting์— ๋Œ€ํ•ด ๋ณธ๊ฒฉ์ ์œผ๋กœ ๋‹ค๋ฃจ๊ธฐ ์ „์—, ์šฐ๋ฆฌ๋Š” 2๊ฐ€์ง€ ํ˜•ํƒœ์˜ Error๊ฐ€ ์กด์žฌํ•จ์„ ์ธ์ง€ํ•ด์•ผ ํ•ฉ๋‹ˆ๋‹ค.
(1) Training Error โ†’ Training Dataset์„ ํ™œ์šฉํ•ด ํ•™์Šต์„ ํ• ๋•Œ ์ƒ๊ธฐ๋Š” Error (2) Generalization Error โ†’ ์ฃผ์–ด์ง„ dataset์ด ์•„๋‹Œ ๋‹ค๋ฅธ ์ถ”๊ฐ€์ ์ธ dataset์— ๋Œ€ํ•œ Error
์‰ฝ๊ฒŒ ๋งํ•ด Training Error๋Š” ์ฃผ์–ด์ง„ ๋ฌธ์ œ์ง‘์„ ๊ฐ€์ง€๊ณ  ์–ด๋А์ •๋„ ํ‹€๋ ธ๋Š”์ง€๋ฅผ ๋งํ•œ๋‹ค๋ฉด, Generalization Error๋Š” ์ƒ์ „ ์ฒ˜์Œ๋ณด๋Š” ์‹œํ—˜๋ฌธ์ œ๋ฅผ ๊ฐ€์ง€๊ณ  ๋น„๊ตํ•˜๋Š” ๊ฒƒ์ž…๋‹ˆ๋‹ค.
๊ทธ๋ ‡๋‹ค๋ฉด ์ด๋Ÿฌํ•œ Generalizablity์— ์˜ํ–ฅ์„ ์ฃผ๋Š” ์š”์†Œ์—๋Š” ์–ด๋–ค๊ฒƒ์ด ์žˆ์„๊นŒ์š”?
1.
ํŠœ๋‹์ด ๊ฐ€๋Šฅํ•œ ํŒŒ๋ผ๋ฏธํ„ฐ๋“ค์˜ ๊ฐœ์ˆ˜ โ†’ ํŒŒ๋ผ๋ฏธํ„ฐ๋“ค์˜ ๊ฐœ์ˆ˜๊ฐ€ ๋งŽ์•„์งˆ์ˆ˜๋ก ์˜ค๋ฒ„ํ”ผํŒ…์— ์ทจ์•ฝํ•ด ์ง‘๋‹ˆ๋‹ค.
2.
ํŒŒ๋ผ๋ฏธํ„ฐ๊ฐ€ ๊ฐ€์งˆ์ˆ˜ ์žˆ๋Š” ๊ฐ’์˜ ๋ฒ”์œ„ โ†’ weight์˜ ๋ฒ”์œ„๊ฐ€ ํด์ˆ˜๋ก ์˜ค๋ฒ„ํ”ผํŒ…์— ์ทจ์•ฝํ•ด ์ง‘๋‹ˆ๋‹ค.
3.
Training Examples ๊ฐœ์ˆ˜ โ†’ ๋ฐ์ดํ„ฐ์˜ ์ˆ˜๊ฐ€ ์ ๋‹ค๋ฉด ์˜ค๋ฒ„ํ”ผํŒ…์— ์ทจ์•ฝํ•ด ์ง‘๋‹ˆ๋‹ค.

4.4.2 Model Selection

์šฐ๋ฆฌ๋Š” ์—ฌ๋Ÿฌ ๋ชจ๋ธ๋“ค์˜ ์„ฑ๋Šฅ์„ ํ‰๊ฐ€ํ•ด์„œ ๋ชจ๋ธ์„ ์„ ์ •ํ•ด์•ผํ•ฉ๋‹ˆ๋‹ค.
multilayer perceptron์„ ์˜ˆ๋กœ ๋“ค๋ฉด, ์šฐ๋ฆฌ๊ฐ€ ์ปจํŠธ๋กค ํ• ์ˆ˜ ์žˆ๋Š” ๋ถ€๋ถ„๋“ค์€ hidden layer์˜ ๊ฐœ์ˆ˜, hidden unit์˜ ๊ฐœ์ˆ˜, ๊ฐ hidden layer์˜ activation function๋ฅผ ์„ ํƒํ•  ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค. ๋ชจ๋ธ์„ ์„ ํƒํ•˜๊ธฐ ์œ„ํ•œ ์„ฑ๋Šฅํ‰๊ฐ€ ์š”์†Œ๋กœ ํ•„์š”ํ•œ ๊ฒƒ์ด ๋ฐ”๋กœ validation data set์ž…๋‹ˆ๋‹ค. ๊ทธ๋ ‡๋‹ค๋ฉด ์™œ ์ด๋Ÿฌํ•œ ๋ฐ์ดํ„ฐ์…‹์ด ํ•„์š”ํ• ๊นŒ์š”?
Model Selection ๊ณผ์ •์—์„œ๋Š” Test dataset์„ ์‚ฌ์šฉํ•ด์„  ์•ˆ๋˜๊ณ , ๊ทธ๋ ‡๋‹ค๊ณ  Training data๋งŒ์„ ์‚ฌ์šฉํ•˜๋ฉด ์˜ฌ๋ฐ”๋ฅธ ๊ฒฐ๊ณผ๋ฅผ ์–ป์„ ์ˆ˜ ์—†์Šต๋‹ˆ๋‹ค.ย ๊ทธย ์ด์œ ๋Š”ย Generalization Error์ดย Training Error๋กœย ์˜ˆ์ƒ๋ ย ์ˆ˜ย ์—†๊ธฐย ๋•Œ๋ฌธ์ž…๋‹ˆ๋‹ค. ํ•™๊ต์—์„œ ์‹œํ—˜์„ ๋ณด๋Š”๋ฐ ์ง€๊ธˆ๊นŒ์ง€ ํ’€์—ˆ๋˜ ๋ฌธ์ œ๋ž‘ ์™„์ „ ๋˜‘๊ฐ™์ด ๋‚ผ๊ป˜~ ๋ผ๊ณ  ๋ง์”€ํ•˜์‹œ๋Š” ๊ฒƒ๊ณผ ๊ฐ™์Šต๋‹ˆ๋‹ค. ์ด๋ ‡๊ฒŒ ๋˜๋ฉด ๊ทธ ์นœ๊ตฌ๊ฐ€ ์ง„์งœ ์•Œ์•„์„œ ํ‘ธ๋Š”๊ฑด์ง€ ์•„๋‹ˆ๋ฉด ๊ทธ๋Œ€๋กœ ์™ธ์›Œ์„œ ํ‘ธ๋Š”๊ฒƒ์ธ์ง€ ๊ตฌ๋ถ„ํ• ์ˆ˜ ์—†๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ์ด๋ฅผย ๊ณ ๋ คํ•ด์„œ,ย Training data์™€ย Test datasetย ์ด์™ธ์˜ย ๋ฐ์ดํ„ฐ๋ฅผย ํ™•๋ณดํ•ด์„œย ๋ชจ๋ธย ์„ ํƒ์—ย ์‚ฌ์šฉํ•ด์•ผํ•ฉ๋‹ˆ๋‹ค.ย  ์ด๋ ‡๊ฒŒย ํ™•๋ณดํ•œย ๋ฐ์ดํ„ฐ๊ฐ€ย validation data set์ด ๋ฉ๋‹ˆ๋‹ค. (6/9์›” ๋ชจ์˜๊ณ ์‚ฌ ๊ฐ™์€ ๋А๋‚Œ(?))
๋ฐ์ดํ„ฐ๋ฅผ ๋‚˜๋ˆŒ ๋•Œ๋Š” Training data์—์„œย ์ž„์˜๋กœย ์„ ํƒํ•œย ์ผ๋ถ€์˜ย ๋ฐ์ดํ„ฐ๋ฅผย validation data set์œผ๋กœย ์‚ฌ์šฉํ•˜๊ณ ,ย ๋‚˜๋จธ์ง€๋ฅผย Training data๋กœย ์‚ฌ์šฉํ•˜๋Š” ๊ฒƒ์ด ์ •์„์ž…๋‹ˆ๋‹ค. (ํ•˜์ง€๋งŒ ๋ฐ์ดํ„ฐ๊ฐ€ ๋ถ€์กฑํ•˜๋‹ค๋ฉด ์ด์•ผ๊ธฐ๊ฐ€ ๋‹ฌ๋ผ์ง„๋‹ค....)

K-fold Cross-Validation

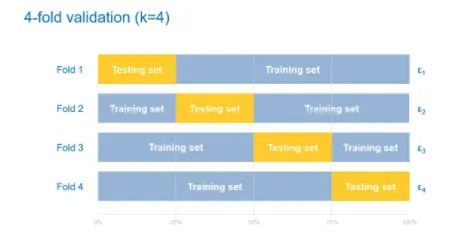
์•ž์„œ ๋งํ–ˆ๋“ฏ ๋ฐ์ดํ„ฐ๊ฐ€ ์™„์ „ ์ถฉ๋ถ„ํ•œ ์ƒํ™ฉ์€ ์—†๋‹ค. ์ด๋Ÿฌํ•œ ๊ฒฝ์šฐ์—๋Š” ๋ถ€์กฑํ•œ ๋ฐ์ดํ„ฐ์…‹์„ ๊ฐ€์ง€๊ณ  ํ•™์Šต์„ ํšจ์œจ์ ์œผ๋กœ ์ง„ํ–‰ํ•˜๊ธฐ ์œ„ํ•ด K-fold Cross-Validation์„ ์ด์šฉํ•œ๋‹ค. Original training data๋ฅผ K๊ฐœ์˜ ๊ฒน์น˜์ง€ ์•Š๋Š” ๋ถ€๋ถ„๋“ค๋กœ ๋‚˜๋ˆˆ ๋’ค ๋ชจ๋ธ training / validation์„ K๋ฒˆ ์ˆ˜ํ–‰ํ•œ๋‹ค.
ํ•œ ๋ฒˆ์˜ ํ•™์Šต ๋•Œ๋งˆ๋‹ค (k-1)๊ฐœ์˜ subset์œผ๋กœ ํ•™์Šต์„ ํ•˜๊ณ , ๋‚˜๋จธ์ง€ ํ•˜๋‚˜๋กœ validation์„ ์ˆ˜ํ–‰ํ•œ๋‹ค. ๋งˆ์ง€๋ง‰์œผ๋กœ training / validation error ๊ฐ€ ๊ฐ ํ•™์Šต ๋•Œ๋งˆ๋‹ค ๋‚˜์˜ค๋ฉด ๊ฐ’๋“ค์„ ํ‰๊ท  ๋‚ด์–ด ์ „์ฒด training / validation error๋ฅผ ๊ตฌํ•œ๋‹ค.

4.4.3 Underfitting or Overfitting?

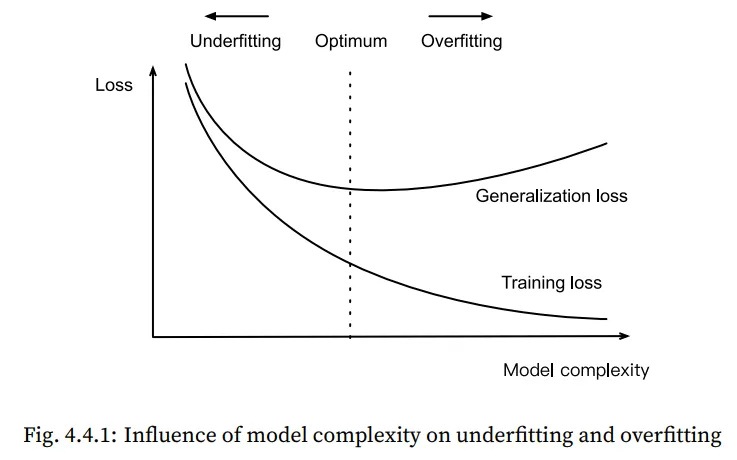
Underfitting์€ ๋ชจ๋ธ์ด ๋„ˆ๋ฌด ๊ฐ„๋‹จํ•˜๊ธฐ ๋•Œ๋ฌธ์— Training Error๊ฐ€ ์ค„์–ด๋“ค์ง€ ์•Š๋Š” ๊ฒƒ์ž…๋‹ˆ๋‹ค. Overfitting์€ ์•ž์—์„œ ์–ธ๊ธ‰ํ–ˆ๋“ฏ์ด, Training Error๊ฐ€ Test dataset์— ์˜ํ•œ Error๋ณด๋‹ค ์•„์ฃผ ์ž‘์€ ๊ฒฝ์šฐ์ž…๋‹ˆ๋‹ค.
์ด ๋‘๊ฐ€์ง€ ๊ฒฝ์šฐ๋Š” ๋ฐ˜๋“œ์‹œ ๋ชจ๋‘ ํ•ด๊ฒฐ์ด ๋˜์–ด์•ผ ํ•˜๋ฉฐ, ์ด๋ฅผ ํ•ด๊ฒฐํ•˜๊ธฐ ์œ„ํ•ด์„  ์™œ ์ด๋Ÿฐ ํ˜„์ƒ์ด ์ผ์–ด๋‚˜๋Š”์ง€ ์•Œ์•„๋ณด์•„์•ผ ํ•ฉ๋‹ˆ๋‹ค.
Underfitting ๊ณผ Overfitting์ด ๋ฐœ์ƒํ•˜๋Š” ๊ฐ€์žฅ ๊ทผ๋ณธ์ ์ธ ์›์ธ 2๊ฐ€์ง€๋ฅผ ๋ฝ‘์ž๋ฉด, ๋ฐ”๋กœ ๋ชจ๋ธ์˜ Complexity์™€ ๋ฐ์ดํ„ฐ์…‹์˜ Size์ž…๋‹ˆ๋‹ค.

1. Complexity(๋ชจ๋ธ์˜ ๋ณต์žก๋„)

๋†’์€ ์ฐจ์ˆ˜์˜ ๋‹คํ•ญ์‹์€ ๋‚ฎ์€ ์ฐจ์ˆ˜์˜ ๋‹คํ•ญ์‹๋ณด๋‹ค ๋ณต์žกํ•˜๊ณ  , ๊ทธ๋ ‡๊ธฐ ๋•Œ๋ฌธ์— ๋” ๋งŽ์€ ํŒŒ๋ผ๋ฏธํ„ฐ์™€ ํ•จ์ˆ˜ ์„ ํƒ์˜ ๋ฒ”์œ„๊ฐ€ ๋„“์Šต๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ๋™์ผํ•œ ์–‘์˜ Training Dataset์„ ๊ฐ€์ •ํ–ˆ์„ ๋•Œ, ๊ณ ์ฐจ ๋‹คํ•ญ์‹์ด ๋” ๋‚ฎ์€ Training Error๋ฅผ ๊ฐ€์ง€๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ํ•˜์ง€๋งŒ ์ฃผ์–ด์ง„ ๋ฐ์ดํ„ฐ ๋Œ€๋น„ ํ•จ์ˆ˜์˜ ์ฐจ์ˆ˜๊ฐ€ ๋„ˆ๋ฌด ๋†’๋‹ค๋ฉด Generalization Loss๊ฐ€ ์ฆ๊ฐ€ํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค.
๋”ฐ๋ผ์„œ ์ ์ ˆํ•œ Complexity๋ฅผ ์„ค์ •ํ•ด์•ผ๋งŒ Underfitting ๊ณผ Overfitting ๋ฌธ์ œ๋ฅผ ํ•ด๊ฒฐํ•  ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค.

2. Dataset Size(๋ฐ์ดํ„ฐ์…‹์˜ ํฌ๊ธฐ)

๋ชจ๋ธ์„ ๊ณ ์ •์‹œ์ผœ๋†“๊ณ , Training Dataset์„ ์ ์œผ๋ฉด ์ ์„์ˆ˜๋ก Overfitting์˜ ์œ„ํ—˜์„ฑ์€ ๋†’์•„์ง‘๋‹ˆ๋‹ค. ๋ฐ˜๋Œ€๋กœ Training data๋ฅผ ๋Š˜๋ฆฌ๋ฉด ๋Š˜๋ฆด์ˆ˜๋ก, Generalization Error๋Š” ๊ฐ์†Œํ•ฉ๋‹ˆ๋‹ค. ๊ฒฐ๊ณผ์ ์œผ๋กœ ๋งํ•˜๋ฉด, ๋ฐ์ดํ„ฐ๋Š” ๋งŽ์„์ˆ˜๋ก ์ข‹์Šต๋‹ˆ๋‹ค! ๋”ฅ๋Ÿฌ๋‹์˜ ์„ฑ๊ณต์€ ๋‹ค์–‘ํ•œ ๋งค์ฒด๋ฅผ ํ†ตํ•ด ์ˆ˜๋งŽ์€ ๋ฐ์ดํ„ฐ์…‹์„ ์ด์šฉํ•˜์—ฌ ํ•™์Šต์„ ์‹œ์ผฐ๊ธฐ ๋•Œ๋ฌธ์— ๊ฐ€๋Šฅํ•ด ์กŒ์Šต๋‹ˆ๋‹ค.

4.4.4 Polynomial Regression

์œ„์— ์ œ์‹œํ•œ Underfitting or Overfitting ์ƒํ™ฉ์„ ๋งŒ๋“ค์–ด ์‹ค์ œ ํ•จ์ˆ˜์—์„œ training loss๊ฐ€ ์–ด๋– ํ•œ ์ƒํ™ฉ์— ์ฒ˜ํ•ด์ง€๋Š”์ง€ ํ™•์ธํ•ด๋ณด์ž.
y=5+1.2xโˆ’3.4x22!+5.6x33!+ฯตย whereย ฯตโˆผN(0,0.12)y=5+1.2 x-3.4 \frac{x^{2}}{2 !}+5.6 \frac{x^{3}}{3 !}+\epsilon \text { where } \epsilon \sim \mathcal{N}\left(0,0.1^{2}\right)
์œ„ ์ฒ˜๋Ÿผ ์ฃผ์–ด์ง„ ์ž„์˜์˜ 3์ฐจ ๋‹คํ•ญ์‹์„ ์ด์šฉํ•ด ๋ฐ์ดํ„ฐ๋ฅผ ๋งŒ๋“ค์–ด๋ด…๋‹ˆ๋‹ค, ์ด ๋•Œ ์‹ค์ œ ๋ฐ์ดํ„ฐ๋กœ ๋ฌ˜์‚ฌํ•˜๊ธฐ ์œ„ํ•ด ฮตํ•ญ์„ ์ถ”๊ฐ€ํ•˜๊ณ  ์ด๋Š” ํ‰๊ท ์ด 0์ด๊ณ  ๋ถ„์‚ฐ์ด (0.1)^2 ์ธ ๋ถ„ํฌ์ž…๋‹ˆ๋‹ค. ์ƒ์‹์ ์œผ๋กœ ์ƒ๊ฐํ•˜์˜€์„ ๋•Œ ์œ„ ์‹์„ ๊ฐ€์žฅ ์ž˜ ๋ฌ˜์‚ฌํ• ์ˆ˜ ์žˆ๋Š” ๋‹คํ•ญ์‹์€ 3์ฐจ ๋‹คํ•ญ์‹์ธ๊ฒƒ์„ ๋‹น์—ฐํžˆ ์•Œ์ˆ˜ ์žˆ์ง€๋งŒ, ์‹ค์ œ ์ƒํ™ฉ์—์„œ๋Š” ์œ„์™€ ๊ฐ™์€ ์‹์ด ์ฃผ์–ด์ง€์ง€๋„ ์•Š์„ ๋ฟ๋”๋Ÿฌ outlier๋“ค๋„ ๋งŽ๊ธฐ ๋•Œ๋ฌธ์— ๋‹คํ•ญ์‹์˜ ์ฐจ์ˆ˜๋ฅผ ์ง์ž‘ํ•˜๊ธฐ๋ž€ ์‰ฝ์ง€ ์•Š์Šต๋‹ˆ๋‹ค.
์ด๋Ÿฌํ•œ ์ƒํ™ฉ์—์„œ ์šฐ๋ฆฌ๋Š” ์—ฌ๋Ÿฌ๊ฐ€์ง€ ์ฐจ์ˆ˜๋กœ ํ•จ์ˆ˜๋ฅผ ๊ฐ€์ •ํ•˜๊ณ  ํ•™์Šต์„ ์‹œ์ผœ๋ณด๋„๋ก ํ•˜๊ฒ ์Šต๋‹ˆ๋‹ค.

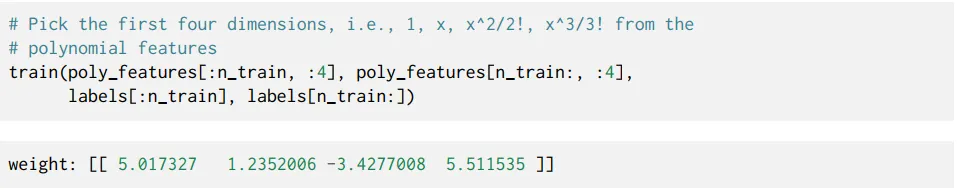
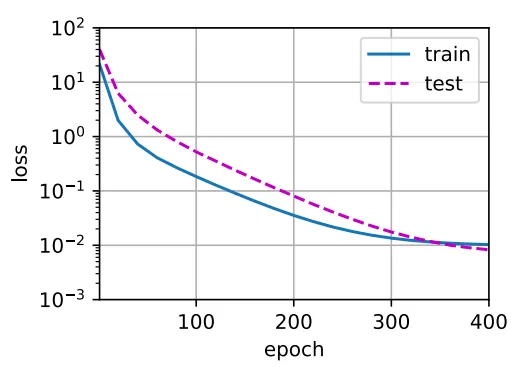
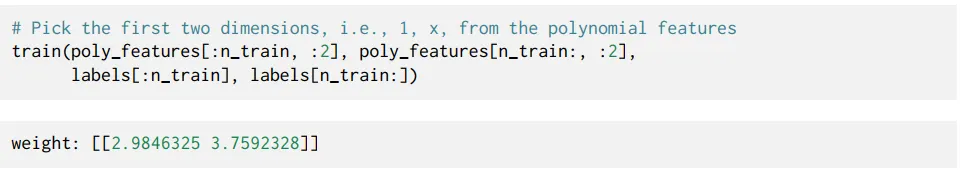
(1) 3์ฐจ ๋‹คํ•ญ์‹ ํ•จ์ˆ˜๋กœ ์ •์˜ํ•˜๊ณ  ํ•™์Šต(weight ๊ฐœ์ˆ˜๊ฐ€ 4๊ฐœ)

training loss๊ฐ€ ํšจ๊ณผ์ ์œผ๋กœ ์ค„์–ด๋“ค๊ณ  ์žˆ์Œ์„ ํ™•์ธํ•  ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค.

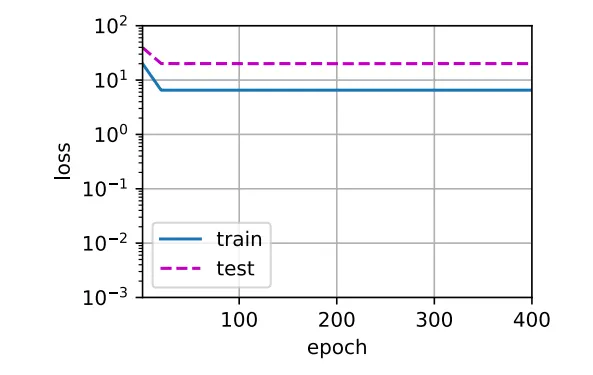
2)1์ฐจ ๋‹คํ•ญ์‹ ํ•จ์ˆ˜๋กœ ์ •์˜ํ•˜๊ณ  ํ•™์Šต(weight ๊ฐœ์ˆ˜๊ฐ€ 2๊ฐœ)

3์ฐจ ํ•จ์ˆ˜๋กœ ํ‘œํ˜„๋˜๋Š” ๋ฐ์ดํ„ฐ๋ฅผ 1์ฐจ ํ•จ์ˆ˜๋กœ ํ‘œํ˜„ํ•˜๋ ค๋‹ค ๋ณด๋‹ˆ ๋‹น์—ฐํ•˜๊ฒŒ๋„ ๋ฐ์ดํ„ฐ๋ฅผ ์ œ๋Œ€๋กœ ๋ฌ˜์‚ฌํ•˜์ง€ ๋ชปํ•˜๊ณ  ์˜ค์ฐจ๊ฐ€ ๋งŽ์ด ๋ฐœ์ƒํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ์ด์— ๋Œ€ํ•œ ๊ฒฐ๊ณผ๋กœ training loss๊ฐ€ ์ผ์ • ๊ฐ’ ์•„๋ž˜๋กœ ๋‚ด๋ ค๊ฐ€์ง€ ์•Š๊ณ  ์žˆ์Šต๋‹ˆ๋‹ค. ์œ„์™€ ๊ฐ™์€ non-linear pattern์„ linear model๋กœ ์ ํ•ฉ์‹œํ‚ค๋ ค ํ•˜๋ฉด Underfitting์ด ๋ฐœ์ƒํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค.

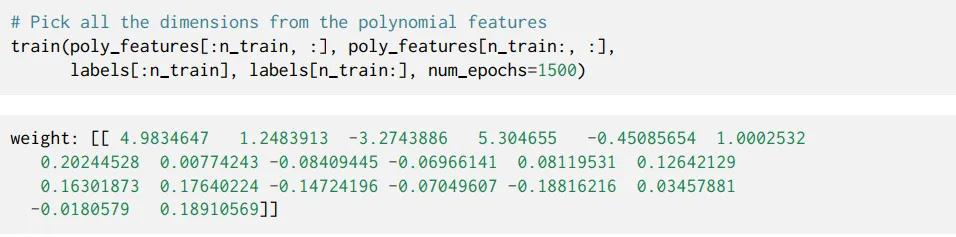
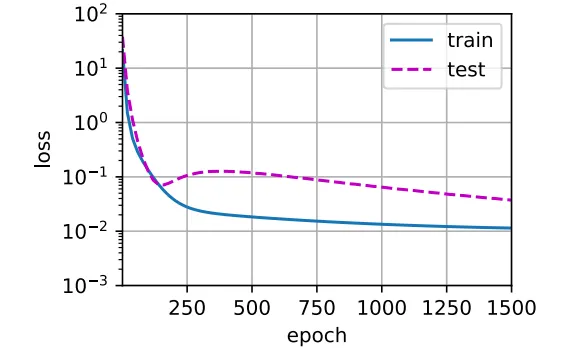
3)๊ณ ์ฐจ(>>3) ๋‹คํ•ญ์‹์œผ๋กœ ์ •์˜ํ•˜๊ณ  ํ•™์Šต (weight ๊ฐœ์ˆ˜๊ฐ€ ๋„ˆ๋ฌด ๋งŽ๋‹ค)

์ด๋Ÿฌํ•œ ์ƒํ™ฉ์—์„œ๋Š” ๊ณ ์ฐจ ๊ณ„์ˆ˜(4์ฐจ ์ด์ƒ)์˜ ๊ฐ’์ด 0์— ๊ฐ€๊นŒ์›Œ์•ผ ํ•œ๋‹ค๋Š” ๊ฒƒ์„ ํ•™์Šตํ•˜๊ธฐ ์œ„ํ•œ ๋ฐ์ดํ„ฐ๊ฐ€ ๋ถ€์กฑํ•œ ์ƒํƒœ์ด๊ณ  ์ด๋Ÿฐ ์ƒํ™ฉ์—์„œ ์ง€๋‚˜์น˜๊ฒŒ ๋ณต์žกํ•œ ๋ชจ๋ธ์€ Training dataset์˜ noise์— ์˜ํ–ฅ์„ ๋งŽ์ด ๋ฐ›๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. Training Loss๋Š” ํšจ๊ณผ์ ์œผ๋กœ ์ค„์ผ ์ˆ˜ ์žˆ์ง€๋งŒ, Test Loss์€ ๋†’์€ ๊ฐ’์„ ์œ ์ง€ํ•˜๊ฒŒ ๋˜์–ด๋ฒ„๋ ค ๊ฒฐ๊ตญ Overfitting์ด ๋ฐœ์ƒํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค.
๊ทธ๋ ‡๋‹ค๋ฉด ์ด๋Ÿฌํ•œ Overfitting, Underfitting issue๋ฅผ ํ•ด๊ฒฐํ•˜๊ธฐ ์œ„ํ•œ ๋ฐฉ๋ฒ•์€ ์–ด๋–ค ๊ฒƒ์ด ์žˆ์„๊นŒ์š”?

4.5 Weight Decay

์•ž์„œ ์ œ์‹œํ•œ Overfitting์„ ์ œ์–ดํ•˜๊ธฐ ์œ„ํ•ด, training datasets์„ ๋Š˜๋ฆฌ๋Š” ๊ฒƒ์ด ์ข‹๋‹ค๊ณ  ํ•˜์˜€์Šต๋‹ˆ๋‹ค. ํ•˜์ง€๋งŒ ๋ฐ์ดํ„ฐ๋ฅผ ์ถ”๊ฐ€์ ์œผ๋กœ ์–ป๋Š”๊ฒƒ์€ ํ˜„์‹ค์ ์œผ๋กœ ์‰ฝ์ง€ ์•Š์€ ์ผ์ž…๋‹ˆ๋‹ค. ๋˜ํ•œ ์ฐจ์ˆ˜๋ฅผ ์กฐ์ ˆํ•˜์—ฌ ํ•จ์ˆ˜์˜ Complexity๋ฅผ ์กฐ์ ˆํ•˜๋Š” ๊ฒƒ๋„ ํ•œ๊ณ„๊ฐ€ ์žˆ์Šต๋‹ˆ๋‹ค.
๊ทธ๋ž˜์„œ ์šฐ๋ฆฌ๋Š” ํ•จ์ˆ˜์˜ Complexity๋ฅผ ์กฐ๊ธˆ ๋” ์šฐ์•„ํ•˜๊ฒŒ ์กฐ์ •ํ•˜๋Š” tool์„ ์‚ฌ์šฉํ•  ๊ฒƒ์ž…๋‹ˆ๋‹ค.

4.5.1 Norms and Weight Decay

๊ทธ ์ค‘ ํ•˜๋‚˜๊ฐ€ ๋ฐ”๋กœ weight decay์ž…๋‹ˆ๋‹ค. regularization technique์ค‘ ํ•˜๋‚˜ ์ธ๋ฐ์š”. ์˜ˆ๋ฅผ ๋“ค์–ด, linear function f(x)=wโŠคxf(\mathbf{x})=\mathbf{w}^{\top} \mathbf{x} ๋ฅผ ๊ฐ€์ • ํ•˜์˜€์„ ๋•Œ, ์ด ํ•จ์ˆ˜์˜ Complexity๋Š” โˆฅwโˆฅ2\|\mathbf{w}\|^{2} ๋กœ ํ‘œํ˜„ ๋ฉ๋‹ˆ๋‹ค. ์ด ๊ฐ’์ด ์ž‘์„ ์ˆ˜๋ก ํ•จ์ˆ˜๊ฐ€ ๋” ๋‹จ์ˆœํ•ด ์ง€๋Š” ๊ฒƒ์ž…๋‹ˆ๋‹ค. (l2l_2 norm ์‚ฌ์šฉ) ์ด ๊ฐ’์„ ๊ณ„์† ์ž‘๊ฒŒ ์œ ์ง€ํ•˜๊ธฐ ์œ„ํ•ด ์ด ๊ฐ’์„ penalty๋กœ ์ทจ๊ธ‰ํ•˜๊ณ  loss์— ์ถ”๊ฐ€๋ฅผ ํ•ฉ๋‹ˆ๋‹ค. training label์— ๋Œ€ํ•œ ์˜ˆ์ธก ์˜ค์ฐจ ์ค„์ด๊ธฐ ์—์„œ ์˜ˆ์ธก ์˜ค์ฐจ + penalty norm ๋‘๊ฐœ ๋‹ค ์ค„์ด๊ธฐ๋กœ ๋ชฉํ‘œ๊ฐ€ ๋ณ€๊ฒฝ์ด ๋˜์—ˆ์Šต๋‹ˆ๋‹ค. ์ด๋ ‡๊ฒŒ ๋˜๋ฉด ๋งŒ์•ฝ weight์ด ๋„ˆ๋ฌด ์ปค์ง€๋ฉด Training Error๋ฅผ ์ค„์ด๋Š” ๊ฒƒ๋ณด๋‹ค weight๋ฅผ ์ค„์ด๋Š” ๊ฒƒ์„ ์šฐ์„ ์ ์œผ๋กœ ํ•˜๊ฒŒ ๋งŒ๋“ค๊ธฐ ๋•Œ๋ฌธ์— complexity๋ฅผ ์กฐ์ ˆํ•  ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค. ์‹์œผ๋กœ ํ‘œํ˜„ํ•˜๋ฉด ์•„๋ž˜์™€ ๊ฐ™์Šต๋‹ˆ๋‹ค.
l(w,b)=1nโˆ‘i=1n12(wโŠคx(i)+bโˆ’y(i))2l(w,b)+ฮป2โˆฅwโˆฅ2l(\mathbf{w}, b)=\frac{1}{n} \sum_{i=1}^{n} \frac{1}{2}\left(\mathbf{w}^{\top} \mathbf{x}^{(i)}+b-y^{(i)}\right)^{2} \\l(\mathbf{w}, b)+\frac{\lambda}{2}\|\boldsymbol{w}\|^{2}
์ด๋Ÿฌํ•œ regularization์„ ์กฐ์ ˆํ•˜๊ธฐ ์œ„ํ•ด, ์šฐ๋ฆฌ๋Š” ฮป\lambda ๋ฅผ ์ถ”๊ฐ€ํ•˜์—ฌ ์กฐ์ ˆํ•ฉ๋‹ˆ๋‹ค. ์ด ๊ฐ’์€ hyperparameter๋กœ์จ ์‚ฌ์šฉ์ž๊ฐ€ ์กฐ์ ˆํ•ด์•ผ ํ•˜๋Š” ๊ฐ’์ž…๋‹ˆ๋‹ค. ์ด๋ ‡๊ฒŒ ๋‹ค์‹œ Loss function์„ ์ •์˜ํ•œ ํ›„ Training์„ ํ†ตํ•ด w\mathbf{w}๋ฅผ ์—…๋ฐ์ดํŠธ ํ•ด ๋‚˜๊ฐ‘๋‹ˆ๋‹ค.
wโ†(1โˆ’ฮทฮป)wโˆ’ฮทโˆฃBโˆฃโˆ‘iโˆˆRx(i)(wโŠคx(i)+bโˆ’y(i))\mathbf{w} \leftarrow(1-\eta \lambda) \mathbf{w}-\frac{\eta}{|\mathcal{B}|} \sum_{i \in \mathcal{R}} \mathbf{x}^{(i)}\left(\mathbf{w}^{\top} \mathbf{x}^{(i)}+b-y^{(i)}\right)
์ด๋Ÿฌํ•œ ๋ฐฉ๋ฒ•์„ ํ†ตํ•ด weight์„ ์ค„์—ฌ๊ฐ€๋ฉฐ complexity๋ฅผ ์ค„์—ฌ ๋‚˜๊ฐ‘๋‹ˆ๋‹ค. ํŒŒ๋ผ๋ฏธํ„ฐ์˜ ๊ฐœ์ˆ˜๋ฅผ ์ง์ ‘ ์กฐ์ ˆํ•ด๊ฐ€๋ฉฐ complexity๋ฅผ ์กฐ์ ˆํ•˜๋Š” ๊ฒƒ๋ณด๋‹จ ํ›จ์”ฌ ๋‚˜์€ ๋ฐฉ๋ฒ•์ธ ๊ฑฐ ๊ฐ™์Šต๋‹ˆ๋‹ค!

4.6 Dropout

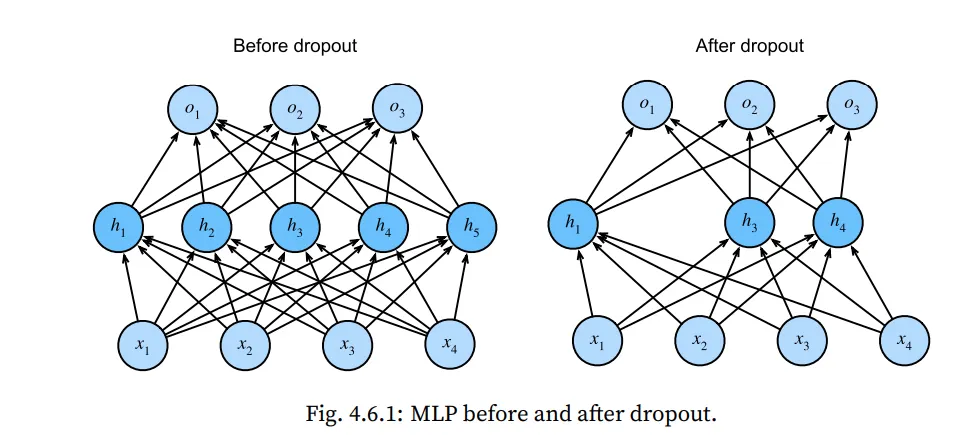
Dropout์€ ์ „์ฒด ๋ชจ๋“  weight๋ฅผ training์— ์ฐธ์—ฌ์‹œํ‚ค์ง€ ์•Š๊ณ , ์ผ๋ถ€๋งŒ ์ฐธ์—ฌ์‹œํ‚ค๋Š” ๋ฐฉ๋ฒ•์ž…๋‹ˆ๋‹ค. ์†๋‹ด์— โ€œ์‚ฌ๊ณต์ด ๋งŽ์œผ๋ฉด ๋ฐฐ๊ฐ€ ์‚ฐ์œผ๋กœ ๊ฐ„๋‹คโ€ ๋ผ๋Š” ๋ง์ด ์žˆ๋“ฏ, ์ด ๋ฐฉ๋ฒ•์€ ์‚ฌ๊ณต์„ ๋ช‡ ๋ช… ์ค„์ด๋Š” ๋ฐฉ์‹์œผ๋กœ ์ง„ํ–‰๋ฉ๋‹ˆ๋‹ค. ์ด ๋•Œ ์ด ์‚ฌ๊ณต๋“ค์„ ํ™•๋ฅ  pp๋ฅผ ๋”ฐ๋ผ ๋ฌด์ž‘์œ„๋กœ ๋ฝ‘๋Š” ๊ฒƒ์ž…๋‹ˆ๋‹ค. ํ•™์Šต์„ ํ•  ๋•Œ๋งˆ๋‹ค ๋งค๋ฒˆ ๋ฌด์ž‘์œ„๋กœ hidden unit์„ ์ œ๊ฑฐํ•ด training์„ ์ง„ํ–‰์‹œํ‚ค๋Š” ๋ฐฉ์‹์ž…๋‹ˆ๋‹ค.

4.6.3 Dropout in Practice .

Dropout์„ hidden layer์— ์‚ฌ์šฉํ•œ๋‹ค๋Š” ๊ฒƒ์€ ๊ฐ hidden unit์— ํ™•๋ฅ  pp ๋ฅผ ๊ฐ€์ง€๊ณ  0์œผ๋กœ ๋งŒ๋“ญ๋‹ˆ๋‹ค. (์ œ๊ฑฐ) ์•„๋ž˜ ๊ทธ๋ฆผ์„ ์‚ดํŽด๋ณด๋ฉด, h2h_2์™€ h5h_5 ๊ฐ€ ์ œ๊ฑฐ๋œ ๊ฒƒ์„ ์•Œ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค. ๊ฒฐ๊ณผ์ ์œผ๋กœ ์ถœ๋ ฅ์„ ๊ณ„์‚ฐํ•  ๋•Œ, ์ถœ๋ ฅ์€ ๋”์ด์ƒ h1,โ€ฆ,h5h_{1}, \ldots, h_{5} ์ค‘ ์–ด๋А ํ•˜๋‚˜์—๋„ ์˜์กดํ•˜์ง€ ์•Š๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ์ด๋ ‡๊ฒŒ ํ•จ์œผ๋กœ์จ ์–ด๋–ค ํŠน์ • feature์— ๋งค๋ชฐ๋˜๋Š” ํ˜„์ƒ์„ ์ค„์—ฌ overfitting์„ ์ค„์ž…๋‹ˆ๋‹ค.

4.7 Forward Propagation, Backward Propagation, and Computational Graphs

์•„๋ž˜ ๋ชจ๋ธ์˜ ํŠน์ง•
โ€ข
ํ•œ ๊ฐœ์˜ hidden layer๋ฅผ ๊ฐ€์ง‘๋‹ˆ๋‹ค.
โ€ข
l2l_2 norm regularization์„ ์ ์šฉํ•˜์˜€์Šต๋‹ˆ๋‹ค.

4.7.1 Forward Propagation

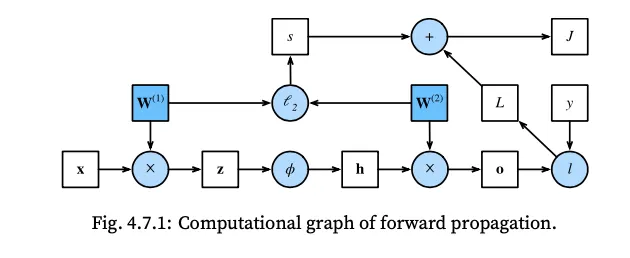
z=W(1)xh=ฯ•(z)o=W(2)hL=l(o,y)s=ฮป2(โˆฅW(1)โˆฅF2+โˆฅW(2)โˆฅF2)J=L+s\mathbf{z}=\mathbf{W}^{(1)} \mathbf{x}\\ \mathbf{h}=\phi(\mathbf{z})\\\mathbf{o}=\mathbf{W}^{(2)} \mathbf{h}\\L=l(\mathbf{o}, y)\\s=\frac{\lambda}{2}\left(\left\|\mathbf{W}^{(1)}\right\|_{F}^{2}+\left\|\mathbf{W}^{(2)}\right\|_{F}^{2}\right)\\J=L+s

4.7.2 Computational Graph of Forward Propagation
4.7.3 Backpropagation

โˆ‚Jโˆ‚L=1ย andย โˆ‚Jโˆ‚s=1โˆ‚Jโˆ‚o=prodโก(โˆ‚Jโˆ‚L,โˆ‚Lโˆ‚o)=โˆ‚Lโˆ‚oโˆˆRqโˆ‚sโˆ‚W(1)=ฮปW(1)ย andย โˆ‚sโˆ‚W(2)=ฮปW(2)โˆ‚Jโˆ‚W(2)=prodโก(โˆ‚Jโˆ‚o,โˆ‚oโˆ‚W(2))+prodโก(โˆ‚Jโˆ‚s,โˆ‚sโˆ‚W(2))=โˆ‚Jโˆ‚ohโŠค+ฮปW(2)โˆ‚Jโˆ‚h=prodโก(โˆ‚Jโˆ‚o,โˆ‚oโˆ‚h)=W(2)โŠคโˆ‚Jโˆ‚oโˆ‚Jโˆ‚z=prodโก(โˆ‚Jโˆ‚h,โˆ‚hโˆ‚z)=โˆ‚Jโˆ‚hโŠ™ฯ•โ€ฒ(z)โˆ‚Jโˆ‚W(1)=prodโก(โˆ‚Jโˆ‚z,โˆ‚zโˆ‚W(1))+prodโก(โˆ‚Jโˆ‚s,โˆ‚sโˆ‚W(1))=โˆ‚Jโˆ‚zxโŠค+ฮปW(1)\frac{\partial J}{\partial L}=1 \text { and } \frac{\partial J}{\partial s}=1 \\ \frac{\partial J}{\partial \mathbf{o}}=\operatorname{prod}\left(\frac{\partial J}{\partial L}, \frac{\partial L}{\partial \mathbf{o}}\right)=\frac{\partial L}{\partial \mathbf{o}} \in \mathbb{R}^{q} \\ \frac{\partial s}{\partial \mathbf{W}^{(1)}}=\lambda \mathbf{W}^{(1)} \text { and } \frac{\partial s}{\partial \mathbf{W}^{(2)}}=\lambda \mathbf{W}^{(2)} \\ \frac{\partial J}{\partial \mathbf{W}^{(2)}}=\operatorname{prod}\left(\frac{\partial J}{\partial \mathbf{o}}, \frac{\partial \mathbf{o}}{\partial \mathbf{W}^{(2)}}\right)+\operatorname{prod}\left(\frac{\partial J}{\partial s}, \frac{\partial s}{\partial \mathbf{W}^{(2)}}\right)=\frac{\partial J}{\partial \mathbf{o}} \mathbf{h}^{\top}+\lambda \mathbf{W}^{(2)} \\ \frac{\partial J}{\partial \mathbf{h}}=\operatorname{prod}\left(\frac{\partial J}{\partial \mathbf{o}}, \frac{\partial \mathbf{o}}{\partial \mathbf{h}}\right)=\mathbf{{W}^{(2)}}^{\top} \frac{ \partial J}{\partial \mathbf{o}} \\ \frac{\partial J}{\partial \mathbf{z}}=\operatorname{prod}\left(\frac{\partial J}{\partial \mathbf{h}}, \frac{\partial \mathbf{h}}{\partial \mathbf{z}}\right)=\frac{\partial J}{\partial \mathbf{h}} \odot \phi^{\prime}(\mathbf{z}) \\ \frac{\partial J}{\partial \mathbf{W}^{(1)}}=\operatorname{prod}\left(\frac{\partial J}{\partial \mathbf{z}}, \frac{\partial \mathbf{z}}{\partial \mathbf{W}^{(1)}}\right)+\operatorname{prod}\left(\frac{\partial J}{\partial s}, \frac{\partial s}{\partial \mathbf{W}^{(1)}}\right)=\frac{\partial J}{\partial \mathbf{z}} \mathbf{x}^{\top}+\lambda \mathbf{W}^{(1)}

4.7.4 Training Neural Networks

Neural Network๋ฅผ training ํ•˜๋Š” ๊ฒฝ์šฐ, Forward Propagation ๊ณผ์ •์—์„œ ์šฐ๋ฆฌ๋Š” ์‹์˜ ๋ฐฉํ–ฅ๋Œ€๋กœ ์—ฐ์‚ฐ์„ ์ˆ˜ํ–‰ํ•˜๊ณ  ๊ทธ ๊ณผ์ •์—์„œ ๊ณ„์‚ฐ๋˜๋Š” ๋ชจ๋“  ๋ณ€์ˆ˜์˜ ๊ฐ’์„ ์ €์žฅํ•œ๋‹ค. ๊ทธ๋ฆฌ๊ณ  ๊ทธ ๊ฐ’๋“ค์ด Backpropagation ๊ณผ์ •์—์„œ ๋‹ค์‹œ ์‚ฌ์šฉ๋ฉ๋‹ˆ๋‹ค.
์ด๋Ÿฌํ•œ ์ด์œ  ๋•Œ๋ฌธ์— Backpropagation๊ณผ์ •์—์„œ ๋ฉ”๋ชจ๋ฆฌ๋ฅผ ๋งŽ์ด ์‚ฌ์šฉํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค.

4.8 Numerical Stability and Initialization

Activation function์„ ์ž˜ ์„ ํƒํ•ด์•ผ ์•Œ๊ณ ๋ฆฌ์ฆ˜์„ Loss๋ฅผ ๋น ๋ฅด๊ฒŒ ์ค„์—ฌ๋‚˜๊ฐˆ์ˆ˜ ์žˆ๊ณ  ๋˜ํ•œ ํŠน๋ณ„ํžˆ ์ •์˜ํ•˜์ง€ ์•Š์•˜๋˜ ์ดˆ๊ธฐ ํŒŒ๋ผ๋ฏธํ„ฐ ๊ฐ’๋“ค์„ ์–ด๋–ป๊ฒŒ ์„ค์ •ํ•ด์•ผํ• ์ง€๋ฅผ ๊ณต๋ถ€ํ•ด์•ผํ•ฉ๋‹ˆ๋‹ค.

4.8.1 Vanishing and Exploding Gradients

์ž…๋ ฅ์ด xx, ์ถœ๋ ฅ์ด oo ์ด๊ณ  LL layers๋ฅผ ๊ฐ€์ง€๋Š” ๋„คํŠธ์›Œํฌ๋ฅผ ๊ฐ€์ •ํ•ด๋ณด๊ฒ ์Šต๋‹ˆ๋‹ค.
h(l)=fl(h(lโˆ’1))ย andย thusย o=fLโˆ˜โ€ฆโˆ˜f1(x)โˆ‚W(l)o=โˆ‚h(Lโˆ’1)h(L)โ‹…โ€ฆโ‹…โˆ‚h(l)h(l+1)โˆ‚W(l)h(l)\mathbf{h}^{(l)}=f_{l}\left(\mathbf{h}^{(l-1)}\right) \text { and thus } \mathbf{o}=f_{L} \circ \ldots \circ f_{1}(\mathbf{x}) \\\partial_{\mathbf{W}^{(l)}} \mathbf{o}=\partial_{\mathbf{h}^{(L-1)}} \mathbf{h}^{(L)} \cdot \ldots \cdot \partial_{\mathbf{h}^{(l)}} \mathbf{h}^{(l+1)} \partial_{\mathbf{W}^{(l)}} \mathbf{h}^{(l)}
์•ž์„œ ์ œ์‹œํ•œ backpropagation ๊ณผ์ •์—์„œ์˜ chain rule ๋•Œ๋ฌธ์— ์ž„์˜์˜ layer์˜ weight์˜ ํŽธ๋ฏธ๋ถ„๊ฐ’์„ ๊ตฌํ•˜๊ธฐ ์œ„ํ•ด์„  ๋งŽ์€ ํ–‰๋ ฌ์˜ ๊ณฑ์˜ ํ˜•ํƒœ๋กœ ํ‘œํ˜„๋ฉ๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ๊ฐ’์ด ์—„์ฒญ๋‚˜๊ฒŒ ์ปค์ง€๊ฑฐ๋‚˜ ์ž‘์•„์ง€๊ฑฐ๋‚˜ ํ•  ๊ฐ€๋Šฅ์„ฑ์ด ์žˆ์Šต๋‹ˆ๋‹ค. ์ด๋ ‡๊ฒŒ ๋˜๋ฉด Loss ๊ฐ’์„ ์ˆ˜๋ ด์‹œํ‚ค๊ธฐ ์–ด๋ ค์›Œ์ง‘๋‹ˆ๋‹ค.
์•ž์„œ ์ œ์‹œํ•œ Sigmoid function์ด ๊ทธ ์ค‘ ํ•œ๊ฐ€์ง€ ์‚ฌ๋ก€์ž…๋‹ˆ๋‹ค.
sigmoid์˜ gradient๊ฐ’์ด ๋Œ€๋žต [-4,4]๋ฒ”์œ„์— ๋“ค์–ด๊ฐ€์ง€ ์•Š๋Š” ์ˆ˜์ด๋ฉด ๊ฐ’์€ ๊ฑฐ์˜ 0์œผ๋กœ ์ˆ˜๋ ดํ•˜๋Š” ๊ฒƒ์„ ํ™•์ธํ• ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ๊ณฑ์˜ ํ˜•ํƒœ๋กœ ํ‘œํ˜„๋˜๋Š” gradient ๊ฐ’์ด 0์— ๊ฐ€๊นŒ์›Œ์ ธ ์†Œ๋ฉธํ•˜๊ฒŒ ๋˜์—ฌ ํ•™์Šต์„ ์ œ๋Œ€๋กœ ์ง„ํ–‰ํ•˜์ง€ ๋ชปํ•˜๊ฒŒ ๋ฉ๋‹ˆ๋‹ค. ๋”ฐ๋ผ์„œ ์šฐ๋ฆฐ sigmoid ๋ณด๋‹ค๋Š” ReLU๋ฅผ ์ฃผ๋กœ ์‚ฌ์šฉํ•ฉ๋‹ˆ๋‹ค.

4.8.2 Parameter Initialization

โ€์–ด๋””์„œ ์ถœ๋ฐœํ•ด์•ผ ์‚ฐ์„ ์ž˜ ๋‚ด๋ ค๊ฐˆ ์ˆ˜ ์žˆ์„๊นŒ?โ€

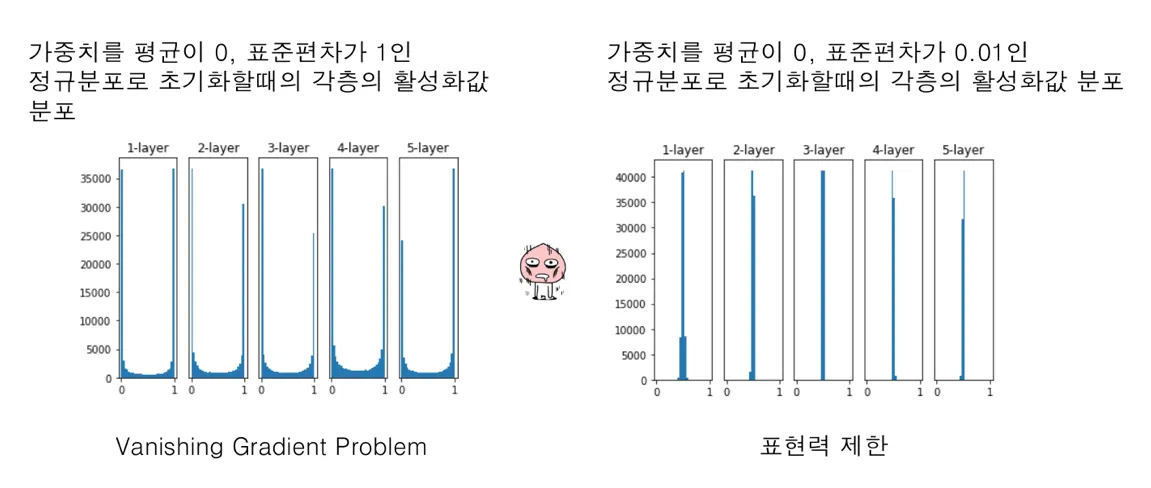
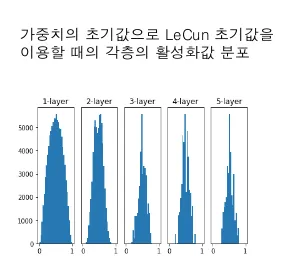
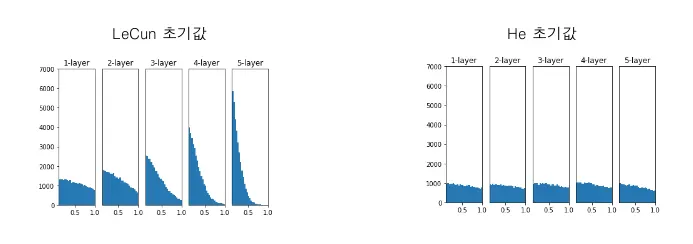
์•ž์„œ ๋‹ค๋ฃฌ Vanishing/Exploding Gradients ๋ฌธ์ œ๋ฅผ ํ•ด๊ฒฐํ•˜๊ธฐ ์œ„ํ•œ ๋ฐฉ๋ฒ•์ด ๋ฐ”๋กœ Weight Initialization์ด๋‹ค. ์œ„์—์„œ ์–ธ๊ธ‰ํ•œ๋“ฏ์ด ๋”ฅ๋Ÿฌ๋‹์€ BackPropagation ๊ณผ์ •์ด ๊ฐ€์žฅ ์ค‘์š”ํ•œ ๊ณผ์ •์ด๋‹ค. ๊ฐ€์ค‘์น˜ ์ดˆ๊ธฐํ™”๋ฅผ 0์œผ๋กœ ํ•˜๋ฉด ์ดˆ๊ธฐ gradient ๊ฐ’์ด ์†Œ๋ฉธ๋˜๊ณ  ๋„ˆ๋ฌด ํฌ๊ฑฐ๋‚˜ ์ž‘์€ ๊ฐ’์œผ๋กœ ํ•˜๊ฒŒ๋˜๋ฉด ํ•™์Šต์ด ์ž˜ ๋˜์ง€ ์•Š๋Š”๋‹ค. ์ด๋Ÿฐ ๊ฐ€์ค‘์น˜ ์ดˆ๊ธฐํ™”๋ฅผ ํ•˜๋Š”๋ฐ ์žˆ์–ด์„œ ๊ฐ€์žฅ ๋งŽ์ด ์‚ฌ์šฉํ•˜๋Š” 2๊ฐ€์ง€ ๋ฐฉ๋ฒ•์ด ์žˆ๋‹ค.
(1) Xavier initialization โ†’ Sigmoid, Tanh
(2) He initialization โ†’ ReLU
LeCunโ€‰Initialization:WโˆผN(0,1nin)Xavierโ€‰Initialization:WโˆผN(0,2nin+noutย )\begin{aligned} &\text LeCun\,Initialization :\quad W \sim N\left(0, \frac{1}{n_{i n}}\right) \\ &\text Xavier\,Initialization :\quad W \sim N\left(0, \frac{2}{n_{i n}+n_{\text {out }}}\right) \end{aligned}
ย Heย initialization:ย WโˆผN(0,2nin)\text { He initialization: } W \sim N\left(0, \frac{2}{n_{i n}}\right)

4.9 Environment and Distribution Shift

Training dataset์—์„œ ์ž˜ ํ›ˆ๋ จํ•˜๊ณ  test dataset์—์„œ ์ž˜ ๋™์ž‘ํ•˜์ง€ ์•Š๋Š”๋‹ค โ†’ Overfitting์ด ์•„๋‹๊นŒ? ๊ฐ€ ์ง€๊ธˆ๊นŒ์ง€์˜ ๊ฒฐ๋ก .
๊ทธ๋Ÿฌ๋‚˜ test dataset๊ณผ training dataset์˜ ๋ถ„ํฌ๊ฐ€ ์•„์˜ˆ ๋‹ค๋ฅด๊ธฐ ๋•Œ๋ฌธ์— ์ž˜ ๋™์ž‘ํ•˜์ง€ ์•Š๋Š” ๊ฒƒ์ผ ์ˆ˜ ์žˆ๋‹ค.

4.9.1 Types of Distribution Shift

1.
Covariate Shift ์ž…๋ ฅ์˜ ๋ถ„ํฌ๋Š” ์‹œ๊ฐ„์— ๋”ฐ๋ผ ๋‹ฌ๋ผ์ง€๋Š”๋ฐ, ์กฐ๊ฑด๋ถ€ ๋ถ„ํฌ์ธ P(yโˆฃx)P(y \mid \mathbf{x}) ๊ฐ€ ๋ฐ”๋€Œ์ง€ ์•Š๋Š” ๊ฒƒ.
2.
Label Shift ์œ„์˜ ๊ฒฝ์šฐ์™€ ๋ฐ˜๋Œ€ - ์ถœ๋ ฅ์˜ ๋ถ„ํฌ๊ฐ€ ๋‹ฌ๋ผ์ง€๊ณ , ์กฐ๊ฑด๋ถ€ ๋ถ„ํฌ P(xโˆฃy)P(\mathbf{x} \mid y) ๊ฐ€ ๋ฐ”๋€Œ์ง€ ์•Š๋Š” ๊ฒƒ
3.
Concept Shift label์˜ ์ •์˜ ์ž์ฒด๊ฐ€ ๋‹ฌ๋ผ์ง€๋Š” ๊ฒƒ

4.9.2 Examples of Distribution Shift

์ž์œจ ์ฃผํ–‰์ฐจ๋ฅผ ๋งŒ๋“ค๊ธฐ ์œ„ํ•ด ๋จธ์‹ ๋Ÿฌ๋‹ ์•Œ๊ณ ๋ฆฌ์ฆ˜์„ ์ด์šฉํ•  ๊ฒฝ์šฐ, ๊ฐ€์žฅ ์ค‘์š”ํ•œ ๊ฒƒ์€ ๋„๋กœ ํƒ์ง€์ž…๋‹ˆ๋‹ค. ์‹ค์ œ ๋ฐ์ดํ„ฐ๋ฅผ ์–ป๊ธฐ์—” ๋„ˆ๋ฌด ๋น„์‹ธ์„œ ๋ Œ๋”๋ง ์—”์ง„ ์ƒ์—์„œ ์–ป์€ ๋ฐ์ดํ„ฐ๋ฅผ ์ด์šฉํ•˜๋Š” ๊ฒฝ์šฐ ๊ฐ€์ƒ ํ™˜๊ฒฝ์—์„œ๋Š” ์ž˜ ๋™์ž‘ํ–ˆ์„ ์•Œ๊ณ ๋ฆฌ์ฆ˜์ด๋ผ๋„, ์‹ค์ œ ํ™˜๊ฒฝ์—์„œ๋Š” ์ œ๋Œ€๋กœ ๋™์ž‘ ํ•˜์ง€ ์•Š์„ ์ˆ˜ ์žˆ์Šต๋‹ˆ๋‹ค. ์™œ๋ƒํ•˜๋ฉด ๋„๋กœ๊ฐ€ ๋„ˆ๋ฌด ๋‹จ์ˆœํ•œ ํ…์Šค์ณ๋กœ ๋˜์–ด ์žˆ์–ด ๋„๋กœ์˜ โ€œํŠน์ง•โ€์„ ๋„ˆ๋ฌด ๋นจ๋ฆฌ ์ตํ˜€๋ฒ„๋ฆฌ๊ธฐ ๋•Œ๋ฌธ์ž…๋‹ˆ๋‹ค.

4.9.3 Correction of Distribution Shift

reference